| Издательский дом ООО "Гейм Лэнд" | ЖУРНАЛ ХАКЕР #145, ФЕВРАЛЬ 2011 г. |
В поисках слабого звена: как найти узкие места в приложениях
Существует такая статистика: 20% кода выполняется 80% времени. Точность ее вряд ли полностью соответствует реальному положению вещей, а вот общий смысл довольно интересен: получается, что оптимизация всего приложения – занятие неблагодарное и глупое, а реальные результаты может дать только оптимизация тех 20% приложения, которые выполняются дольше всего. Причем найти эти 20% не так уж и сложно.
В этой статье мы будем говорить о профилировании. Если верить Википедии, профилирование есть не что иное, как "сбор характеристик работы программы, таких как время выполнения отдельных фрагментов, число верно предсказанных условных переходов, число кэш-промахов и так далее". В переводе на русский язык это означает "выявление узких мест программы" (или, как говорят англофилы, "бутылочных горлышек"), а именно – всех тех участков кода, на которых программа начинает "пробуксовывать", заставляя пользователя ждать.
Простейшее профилирование можно произвести голыми руками (и ниже я покажу, как это сделать), однако лучше положиться на сообщество, представители которого уже создали все необходимые инструменты. Первый и наиболее популярный инструмент носит имя GNU Profiler (или gprof). Он испокон веков используется для профилирования кода, генерируемого компилятором GCC. Второй - GNU Coverage testing tool (gcov), утилита для более детального анализа производительности. Третий - набор инструментов отладки и профилирования под общим именем Google Performance Tools (сокращенно GPT). Ну а четвертый - это Valgrind, который хоть и предназначен для поиска ошибок работы с памятью, но содержит в своем арсенале ряд утилит для анализа производительности программ.
Начнем, как и полагается, с классики.
GNU Profiler
GNU Profiler (gprof) - один из старейших профайлеров, доступных для операционных систем типа UNIX. Он входит в состав пакета gcc, и потому может быть использован для профилирования программ, написанных на любом поддерживаемом им языке (а это не только C/C++, но и Objective-C, Ada, Java).
Сам по себе gprof не является инструментом профилирования, а лишь позволяет отобразить профильную статистику, которая накапливается приложением во время работы (само собой разумеется, по умолчанию никакое приложение этого не делает, но может начать, если собрать программу с аргументом '-pg').
Рассмотрим, как это работает в реальных условиях. Чтобы ощутить все достоинства gprof, мы применим ее не к какому-нибудь абстрактному, искусственно созданному приложению, а к самому настоящему повседневно используемому. Пусть это будет gzip.
Получаем и распаковываем исходники архиватора:
$ wget www.gzip.org/gzip-1.3.3.tar.gz

$ tar -xzf gzip-1.3.3.tar.gz

$ cd gzip-1.3.3
Устанавливаем инструменты, необходимые для сборки (в Ubuntu это делается через инсталляцию мета-пакета build-essential):
$ sudo apt-get install build-essential
Запускаем конфигуратор сборки, передав в переменной окружения CFLAGS аргумент '-pg':
$ CFLAGS='-pg' ./configure
Компилируем программу:
$ make
Теперь у нас есть бинарник gzip, способный вести статистику своего исполнения. Каждый его запуск будет сопровождаться генерацией файла gmon.out:
$ ./gzip ~/ubuntu-10.10-desktop-i386.iso

$ ls -l gmon.out

-rw-r--r-- 1 j1m j1m 24406 2010-11-19 14:47 gmon.out
Этот файл не предназначен для чтения человеком, но может быть использован для создания подробного отчета об исполнении:
$ gprof ./gzip gmon.out > gzip-profile.txt
Наиболее важная часть полученного файла показана на скриншоте.
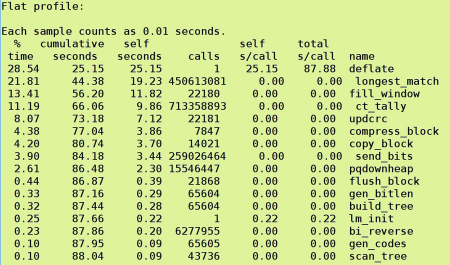
Каждая строка - это статистика исполнения одной функции, столбцы - различные показатели. Нас интересуют первый, третий, четвертый и седьмой столбцы. Они отображают информацию об общем количестве времени, затраченном на исполнение функции (первый столбец - в процентах, третий - в секундах), количестве ее вызовов и имени.
Попробуем проанализировать отчет. Первой в списке идет функция deflate, которая была вызвана всего один раз, но "сожрала" 29% всего времени исполнения программы. Это реализация алгоритма компрессии, и, если бы перед нами стояла задача оптимизировать gzip, мы должны были бы начать именно с нее. 22% времени ушло на исполнение функции longest_match, но, в отличие от deflate, она была вызвана аж 450 613 081 раз, поэтому каждый отдельный вызов функции занимал ничтожное количество времени. Это второй кандидат на оптимизацию. Функция fill_window отняла 13% всего времени и была вызвана "всего" 22 180 раз. Возможно, и в этом случае оптимизация могла бы дать результаты.
Промотав файл отчета до середины (кстати, сразу за таблицей идет подробная справка обо всех ее столбцах, что очень удобно), мы доберемся до так называемого "графа вызовов" (Call graph). Он представляет собой таблицу, разбитую на записи, отделенные друг от друга пунктиром (повторяющимися знаками минуса). Каждая запись состоит из нескольких строк, при этом вторая строка вопреки здравому смыслу называется "первичной" и описывает функцию, которой посвящена запись. Строкой выше располагается описание вызывающей ее функции, а ниже - вызываемых ей.
Столбцы содержат следующую информацию (слева направо): индекс (index, он есть только в первичной строке и, по сути, ничего не значит); процент времени, который уходит на выполнение функции (% time); количество времени, затрачиваемое на ее выполнение в секундах (self); количество времени, затрачиваемое на выполнение функции и всех вызываемых ею функций (children); количество вызовов функции (called) и ее имя (name).
Граф вызовов оказывается очень полезен, когда речь заходит об оптимизации чужого кода. Становятся видны не только узкие места программы, но и вся логика ее работы, которая может быть неочевидна при изучении исходников.
GNU Coverage testing tool
Кроме gprof, компилятор GCC имеет в своем составе еще один инструмент профилирования, который позволяет получить более детальный отчет о выполнении приложения. Утилита называется gcov и предназначена для генерации так называемого аннотированного исходного кода, который напротив каждой строки содержит количество ее исполнений. Это может понадобиться для более глубокого изучения проблем приложения, когда функции, виновные в "тормозах", найдены, а суть проблемы так и остается неясна (например, непонятно, какая строка в многократно вложенном цикле внутри длиннющей функции несет ответственность за аномальное падение производительности).
Gcov не может полагаться на статистику, генерируемую приложением при сборке с флагом '-pg', и требует пересборки с флагами '-fprofile-arcs' и '-ftest-coverage':
$ CFLAGS='-fprofile-arcs -ftest-coverage'

./configure && make
Далее приложение необходимо запустить:
$ ./gzip ~/ubuntu-10.10-desktop-i386.iso
Для каждого файла исходного кода будет сгенерирован граф вызовов, на основе которого можно создать подготовленный для чтения человеком аннотированный исходник:
$ gcov deflate.c

File 'deflate.c'

Lines executed:76.98% of 139

deflate.c:creating 'deflate.c.gcov'
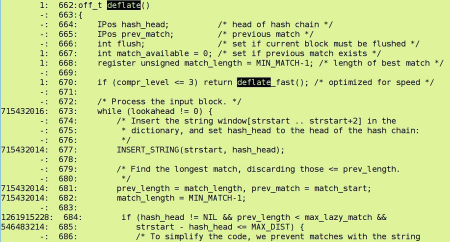
Полученный в результате файл состоит из трех колонок: количество исполнений строки, номер строки и сама строка. При этом для строк, не содержащих кода, в первой колонке будет стоять знак минуса, а для строк, ни разу не выполненных - последовательность шарпов: #####.
Google Performance Tools
Google Performance Tools (сокращенно GPT) - это разработка сотрудников Google, предназначенная для поиска утечек памяти и узких мест приложений. Как и gprof, GPT не является внешней по отношению к тестируемому приложению программой и заставляет его самостоятельно вести статистику своего исполнения. Однако используется для этого не внедренный на этапе сборки приложения код, а библиотеки, которые могут быть прилинкованы к приложению во время сборки или подключены при запуске.
Всего разработчикам доступно две подключаемых библиотеки: tcmalloc (которая, по уверению авторов GPT, представляет собой самую быструю на свете реализацию функции malloc, а также позволяет производить анализ того, как память расходуется, выделяется и течет) и profiler, генерирующая отчет о выполнении программы, наподобие gprof. Также в комплект входит утилита pprof, предназначенная для анализа и визуализации накопленных данных.
Исходный код, а также rpm- и deb-пакеты всего этого набора доступны на официальной страничке (code.google.com/p/google-perftools), однако я бы не советовал заморачиваться с ручной установкой, так как набор доступен в стандартных репозиториях Fedora и Ubuntu, и его можно установить одной простой командой:
$ sudo apt-get install google-perftools \libgoogle-perftools0
libgoogle-perftools-dev
Далее можно приступать к профилированию. Легче всего это сделать, просто подсунув нужную библиотеку прямо во время запуска программы с помощью LD_PRELOAD:
$ LD_PRELOAD=/usr/lib/libprofiler.so.0.0.0 \

CPUPROFILE=gzip-profile.log ./gzip \

/home/j1m/ubuntu-10.10-desktop-i386.iso
Однако сами гугловцы не советуют применять этот метод (очевидно из-за проблем с программами, написанными на C++), рекомендуя линковать библиотеку во время сборки. Что ж, не будем спорить.
Для экспериментов возьмем все тот же gzip и повторно пересоберем его, слинковав бинарник с нужной библиотекой:
$ cd ~/gzip-1.3.3

$ make clean

$ ./configure

$ LDFLAGS='-lprofiler' ./configure && make
Теперь gzip вновь готов вести лог своего исполнения, но не будет делать этого по умолчанию. Чтобы активировать профайлер, необходимо объявить переменную окружения CPUPFOFILE и присвоить ей путь до файла профиля:
$ CPUPROFILE=gzip-cpu-profile.log ./gzip \

~/ubuntu-10.10-desktop-i386.iso

PROFILE: interrupts/evictions/bytes = 4696/946/91976
Как и в случае с gprof, получившийся отчет имеет бинарную форму и может быть прочитан только с использованием специальной утилиты. В GPT ее роль выполняет perl-скрипт pprof (в Ubuntu во избежание путаницы с другой одноименной утилитой он переименован в google-pprof), который может генерировать не только таблицы и аннотированные исходники на манер gcov, но и визуальные графы вызовов. Всего существует 11 типов вывода этой утилиты, за каждым из которых закреплен соответствующий аргумент командной строки:
- Текстовый (--text) - таблица, подобная выводу gprof;
- Callgrind (--callgrind) - вывод в формате, совместимом с утилитой kcachegrind (из пакета valgrind);
- Графический (--gv) - граф вызовов, немедленно отображаемый на экране;
- Листинг (--list=<regexp>) - аннотированный листинг указанной функции;
- Дизассемблированный листинг (--disasm=<regexp>) - аннотированный дизассемблированный листинг указанной функции;
- Символьный (--symbols) - листинг декодированных символьных имен;
- Графический файл (--dot, --ps, --pdf, --gif) - граф вызовов, сохраняемый в файл;
- Сырой (--raw) - подготовка бинарного файла профиля к передаче по сети (перекодируется с помощью печатаемых символов).
Наибольший интерес для нас представляют текстовый ('--text') и графический ('--gv') типы вызовов. Только они могут дать полную информацию о выполнении приложения и всех его проблемных местах. Текстовый вывод генерируется следующим образом:
$ google-pprof --text ./gzip gzip-cpu-profile.log
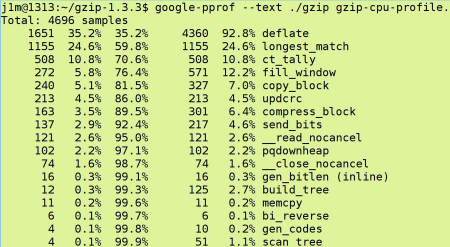
Как видно на скриншоте, вывод представляет собой таблицу с перечислением всех функций и затрат на их исполнение. На первый взгляд она кажется очень похожей на таблицу, генерируемую утилитой gprof, но это не так. Будучи всего лишь библиотекой, GPT не может вести статистику исполнения программы так же детально и точно, как это делает код, внедренный прямо в приложение. Поэтому вместо записи всех фактов вызова и выхода из функций (поведение программы, собранной с флагом '-pg'), GPT применяет метод, называемый сэмплированием. Сто раз в секунду библиотека активирует специальную функцию, в задачи которой входит сбор данных о том, в какой точке в текущий момент происходит выполнение программы, и запись этих данных в буфер. По завершению работы программы из этих данных формируется и записывается на диск профильный файл.
Именно поэтому в выводе pprof нет информации о том, сколько раз функция была вызвана за время работы программы, или сколько процентов времени ушло на ее исполнение. Вместо этого для каждой функции указывается количество проверок, во время которых было выяснено, что в данный момент программа занималась исполнением этой функции. Поэтому количество проверок, приведенное для каждой функции, можно смело считать за общее время ее исполнения.
Во всем остальном таблица сильно напоминает вывод gprof: по функции на строку, по показателю на столбец. Всего столбцов шесть:
- Количество проверок для данной функции;
- То же число в процентах от общего количества проверок;
- Процент проверок на все остальные функции программы;
- Количество проверок для данной функции и всех ее потомков;
- То же число в процентах от общего количества проверок;
- Имя функции.
Поначалу такой подход к измерению времени исполнения кажется слишком неточным, но если сравнить таблицы, полученные с помощью gprof, с таблицами pprof, становится ясно, что они показывают одинаковую картину. Более того, GPT позволяет изменить количество проверок на секунду времени с помощью переменной окружения CPUPROFILE_FREQUENCY, так что точность можно увеличить в десять, сто или тысячу раз, если того требует ситуация (например, если необходимо профилировать исполнение очень небольшой программы).
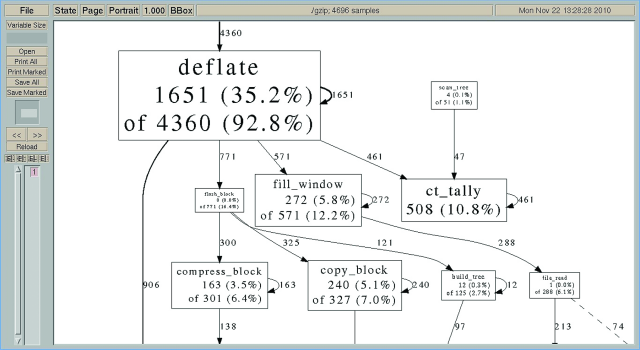
Несомненным достоинством GPT перед gprof является умение представлять информацию в графическом виде. Для активации этой функции pprof следует запускать с флагом '--gv' (кстати, для показа графа будет использована одноименная утилита):
$ google-pprof --gv ./gzip gzip-cpu-profile.log
Генерируемый в результате выполнения этой функции граф вызовов функций очень наглядный и гораздо более простой для восприятия и изучения, чем аналогичный текстовый граф, генерируемый командой gprof. Имя и статистика исполнения каждой функции размещены в прямоугольниках, размер которых прямо пропорционален количеству времени, затраченному на исполнение функции. Внутри прямоугольника размещены данные о том, сколько времени ушло на исполнение самой функции и ее потомков (время измеряется в проверках). Связи между прямоугольниками указывают на очередность вызова функций, а числовые значения, указанные рядом со связями - на время исполнения вызываемой функции и всех ее потомков.
Еще одно достоинство GPT заключается в способности использовать разные уровни детализации для вывода данных, позволяя пользователю самому выбирать единицы дробления. По умолчанию в качестве такой единицы используется функция, поэтому любой вывод pprof логически разделен на функции. Однако при желании в качестве единицы дробления можно использовать строки исходного кода (аргумент '--lines'), файлы ('--files') или даже физические адреса памяти ('--addresses'). Благодаря такой функциональности GPT очень удобно использовать для поиска узких мест в больших приложениях, когда сначала ты анализируешь производительность на уровне отдельных файлов, затем переходишь к функциям и, наконец, находишь проблемное место на уровне исходного кода или адресов памяти.
И последнее. Как я уже говорил выше, GPT - это не только хороший профайлер, но и инструмент для поиска утечек памяти, поэтому у него есть один очень приятный побочный эффект в виде способности к анализу потребления памяти приложением. Для этого приложение должно быть собрано или запущено с поддержкой библиотеки tcmalloc, а в переменную HEAPPROFILE записан адрес для размещения профильного файла. Например:
$ LD_PRELOAD=/usr/lib/libtcmalloc.so.0.0.0 \

HEAPPROFILE=gzip-heap-profile.log \

./gzip ~/ubuntu-10.10-desktop-i386.iso

Starting tracking the heap

Dumping heap profile to gzip-heap-profile.log.0001.heap (Exiting)
К полученному файлу будет добавлено окончание 0000.heap. Если натравить на этот файл утилиту pprof и указать флаг '--text', она выведет на экран таблицу функций и уровень потребления памяти каждой из них. Столбцы значат все то же самое, что и в случае обычного профилирования, с тем исключением, что вместо количества проверок и их процентных отношений таблица теперь содержит количество потребляемой памяти и процент от общего потребления памяти.
При необходимости эту информацию можно получить в графическом виде, а также изменить единицы дробления. Библиотека может быть настроена с помощью различных переменных окружения, наиболее полезная из которых носит имя HEAP_PROFILE_MMAP. Она включает профилирование для системного вызова mmap (по умолчанию GPT собирает статистику только для вызовов malloc, calloc, realloc и new).
Пара слов о Valgrind
В последней части статьи мы кратко рассмотрим способы использования инструмента Valgrind для профилирования приложений. Valgrind - это очень мощный отладчик памяти, который способен найти такие ошибки работы с памятью, о которых другие утилиты даже не подозревают. Он имеет модульную архитектуру, которая с течением времени позволила ему обрасти несколькими плагинами, не относящимися напрямую к отладке. Всего таких плагина три:
- Cachegrind - позволяет собирать статистику по попаданию данных и инструкций программы в кэш первого и второго уровней процессора (мощный и сложный инструмент, который полезен при выполнении профилирования низкоуровневого кода).
- Massif - профайлер кучи, схожий по функциональности с аналогом из пакета GPT.
- Callgrind - профайлер, во многом похожий на таковой в gprof и GPT.
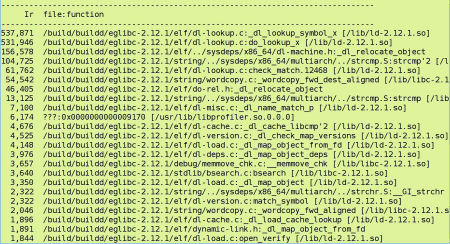
По умолчанию в качестве основного плагина Valgrind использует memcheck (отладчик памяти), поэтому для его запуска в режиме профилирования необходимо указать нужный плагин вручную. Например:
$ valgrind --tool=callgrind ./program
После этого в текущем каталоге будет создан файл с именем callgrind.out.PID-программы, который можно проанализировать с помощью утилиты callgrind_annotate или графической программы kcachegrind (устанавливается отдельно). Я не буду расписывать формат генерируемых этими программами данных (он хорошо представлен в одноименных man-страницах), скажу лишь, что callgrind_annotate лучше запускать с флагом '--auto', чтобы он смог самостоятельно найти файлы исходных текстов программы.
Для анализа расхода памяти Valgrind следует запускать с аргументом '--tool=massif'. После чего в текущем каталоге появится файл massif.out.PID-программы, который может быть проанализирован с помощью утилиты ms_print. В отличие от pprof, она умеет выводить данные не только в виде стандартной таблицы, но и генерировать красивые ascii-art графики.
Выводы
Такие инструменты, как gprof, gcov и GPT, позволяют провести анализ работы приложения и выявить все его узкие места вплоть до отдельной процессорной инструкции, а подключив к процессу профилирования еще и Valgrind, можно добиться удивительных результатов.
INFO
По умолчанию gprof не выводит профильной информации для функций библиотеки libc, но ситуацию можно исправить, установив пакет libc6-prof и собрав тестируемое с библиотекой libc_p: "export LD_FLAGS='-lc_p'".
Активировать профайлер GPT можно не только с помощью переменной окружения CPUPROFILE, но и обрамив тестируемый участок кода функциями ProfilerStart() и ProfilerStop(), которые объявлены в google/profiler.h.
WARNING
Из-за требований к безопасности GPT не сработает в отношении приложений с установленным битом SUID.