| Издательский дом ООО "Гейм Лэнд" | ЖУРНАЛ ХАКЕР #127, ИЮЛЬ 2009 г. |
CUDA катится мир? Параллельные вычисления с использованием видеокарты
Игорь Антонов
С тех пор, как на графических процессорах стали доступны неграфические вычисления, многое изменилось. Можно найти не один пример того, как кластер из нескольких машин с мощными видеокартами мог поспорить с бешено дорогими суперкомпьютерами. Так за счет чего получается такой прирост производительности и так ли все просто на самом деле?
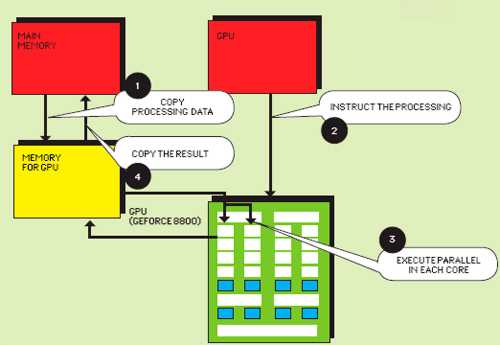
Еще в начале февраля 2007 года на всеобщее обозрение был представлен первый готовый комплект инструментов для доступа к инструкциям графического ускорителя. CUDA Toolkit/CUDA SDK (тогда еще в бета-исполнении) позволяла реализовать на языке программирования Си алгоритмы, выполняющиеся на графических процессорах ускорителей GeForce восьмого поколения и старше. В качестве API используются транслированные на C выражения, которые стало возможным задействовать в любых приложениях. Правда, взять и увеличить производительность любого приложения в n раз не выйдет. Благодаря CUDA возможно оптимизировать лишь ту частью приложения, которую можно распараллелить, а это, увы, далеко не всегда очевидная задача.
CUDA на пальцах
В чем отличается основной процессор системы (CPU) и процессор видеокарты? CPU изначально приспособлен для решения задач общего плана и работает с произвольно адресуемой памятью. Программы на CPU могут обращаться напрямую к любым ячейкам линейной и однородной памяти. Для GPU это не так. В CUDA имеется целых 5 видов памяти. Читать можно из любой ячейки, доступной физически, но вот записывать – не во все ячейки. Причина заключается в том, что GPU в любом случае представляет собой специфическое устройство, предназначенное для конкретных целей. Это ограничение введено ради увеличения скорости работы определенных алгоритмов и снижения стоимости оборудования.
Извечная проблема большинства вычислительных систем заключена в том, что память работает медленнее процессора. Производители CPU решают ее путем введения кешей. Наиболее часто используемые участки памяти помещается в сверхоперативную или кэш-память, работающую на частоте процессора. Это позволяет сэкономить время при обращении к наиболее часто используемым данным и загрузить процессор собственно вычислениями. Замечу, что кэши для программиста фактически прозрачны. Как при чтении, так и при записи данные не попадают сразу в оперативную память, а проходят через кэши. Это позволяет, в частности, быстро считывать некоторое значение сразу же после записи. На GPU (здесь подразумевается видеокарты GF восьмой серии) кеши тоже есть, и они тоже важны, но этот механизм не такой мощный, как на CPU. Во-первых, кэшируется не все типы памяти, а во-вторых, кэши работают только на чтение. На GPU медленные обращения к памяти скрывают, используя параллельные вычисления. Пока одни задачи ждут данных, работают другие, готовые к вычислениям. Это один из основных принципов CUDA, позволяющих сильно поднять производительность системы в целом.
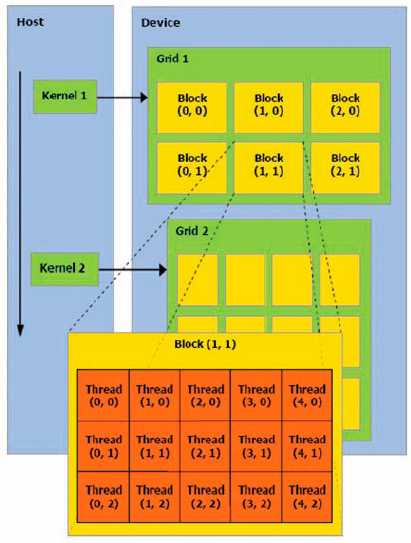
Вычислительная архитектура CUDA основана на концепции одна команда на множество данных (Single Instruction Multiple Data, SIMD) и понятии мультипроцессора. Концепция SIMD подразумевает, что одна инструкция позволяет одновременно обработать множество данных. Мультипроцессор — это многоядерный SIMD процессор, позволяющий в каждый определенный момент времени выполнять на всех ядрах только одну инструкцию. Логически устройство можно представить как набор мультипроцессоров плюс драйвер CUDA (Compute Unified Device Architecture).
Особенностью архитектуры CUDA является блочно-сеточная организация, необычная для многопоточных приложений. Не все задачи подходят для SIMD архитектур. Если ваша задача для этого не пригодна, возможно, не стоит использовать GPU. Но если вы твердо решили использовать GPU, нужно стараться разбить алгоритм на такие части, чтобы они могли эффективно выполняться в стиле SIMD.
GPU предназначен для вычислений с большим параллелизмом и интенсивной арифметикой. Это объясняется тем, что у него гораздо большее число транзисторов отведено на обработку данных, а не на управление исполнением (flow control). GPU демонстрируют хорошие результаты в параллельной обработке данных. А также в том случае, когда с одной и той же последовательностью действий обрабатывает большой объём данных.
Установка CUDA в систему
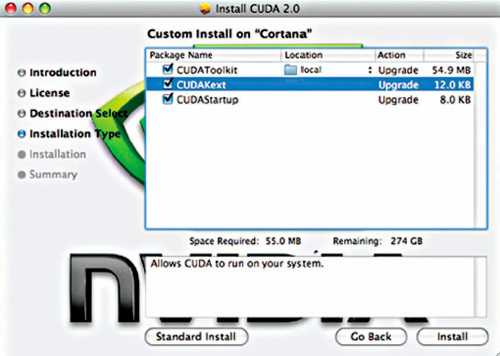
До недавнего времени GPU могли программироваться только посредством графических API. Отсюда автоматически возникают недостатки в лице длительно времени для изучения, а также накладные расходы, возникающий за счет использования промежуточного звена. CUDA – это расширение языка C, а поэтому изучить его намного проще. Вообще, все что нужно для того чтобы начать использовать CUDA - обзавестись соответствующим SDK, а также скачать с официального сайта NVIDIA драйвер CUDA, который связывается с DirectX, OpenGL и С-компилятором для GPU. Помимо этого необходимо заинсталить и специальную среду разработки CUDA Toolkit и обновить драйвера для видюхи. Установить CUDA не составит труда и на Linux, например на самом официальном сайте есть подробные инструкции по установке UDA на Ubuntu. При этом на компьютер устанавливается все, необходимое для работы с CUDA, включая runtime и компилятор nvcc. Сам компилятор фактически представляет собой препроцессор, обрабатывающий код и строящий отдельный код для GPU и CPU. Для компиляции кода для CPU (включая код, необходимый для запуска ядра) nvcc использует обычный C/C++ компилятор (на Linux'е он использует gcc).
Замечу, что именно NVIDIA является разработчиком и обладателем патента на эту технологию, хотя она и поддерживается другими производителями, например, ATI. Важное требование — видеокарта должна обладать, как минимум, 512 Мб памяти — в противном случае GPU-клиент сильно загрузит машину.
Расправляемся с хешами
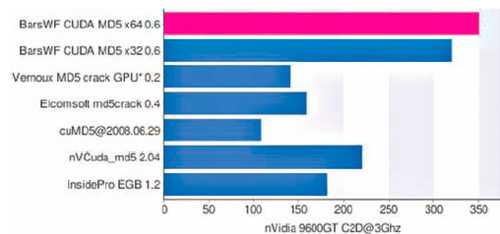
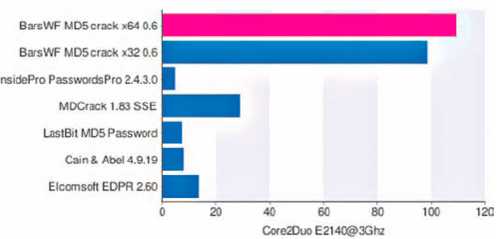
Первое и самое простое из того, что можно сделать, чтобы проверить функциональность CUDA, - попробовать пробрутить какой-нибудь кеш и сравнить результаты с теми, что дают утилиты из нашего брутфорс-набора (читай статью "Лучшие инструменты пентестера". Одна из таких утилит – BarsWF (http://3.14.by/ru/md5), разработка Сваричевскогшо Михаила. На текущий момент, разработчиком достигнут результат в 350 миллионов ключей в секунду. Синтаксис для запуска следующий: BarsWF_SSE2_x64.exe -h 21685d282d79098b89bdf5 a916b66c90 -X "030405313233" -min_len 12 Где -X добавляет дополнительные значения для перебора, — min_len вносит минимальную длину пароля (не более 15). Перед запуском не поленись скачать самый последний драйвер с поддержкой CUDA (http://www.nvidia.com/object/cuda_get.html) или AMD/Brook, если используешь видюху на базе AMD (http://ati.amd.com/support/driver.html).
Для взлома хешей с использованием CUDA есть и другие проекты: Vernoux Md5 crack (http://bvernoux.free.fr/md5/index.php), Lightning Hash Cracker (http://www.elcomsoft.com/lhc.html), cuMD5 (http://forums.nvidia.com/index.php?showtopic=71548), nVCuda_md5 (https://forum.antichat.ru/thread62728.html), InsidePro EGB (http://www.insidepro.com/eng/egb.shtml).
Ну, хорошо с md5 разобрались - а как быть с другими хешами? Специальная версия Rainbowcrack (project-rainbowcrack.com), заточенная под CUDA, тебе в помощь. Только вдумайся в цифры: для NTLM хеша скорость перебора, используя мощности графического процессора, составляет 500 миллионов паролей в секунду. А если вместо брутфорса использовать rainbow-таблицы, получаем вообще астрономическую цифру: почти 73904 миллионов паролей в секунду! Увы, бесплатная версия Rainbowcrack не позволяет полностью насладиться всеми благами CUDA.
Восстанавливаем пароль
Программа Distributed Password Recovery компании ElcomSoft предназначена для распределенного нахождения забытых паролей к различным типам документов, причем некоторые из алгоритмов оптимизированны на использования CUDA-ускорения. Повезло тем, кто забыл пароль олт документов Word 2007, Excel 2007, PowerPoint, Project 2007, а также для своей учетке в Windows (LM/NTLM). Технология ускорения на GPU разгружает CPU от наиболее ресурсоёмких частей алгоритма, перенося их на CUDA-совместимые графические процессоры. Требования к видеокартам просты, главное, чтобы объём видеопамяти был не менее 256 МБ. EDPR состоит из трех компонентов: сервер, агент и консоль. Сервер устанавливается на один из компьютеров в сети, он управляет процессом перебора паролей. На остальные компьютеры в сети устанавливается агент, перебирающий порции паролей. По заявлению разработчиков, система с несколькими видеокартами NVIDIA способна перебрать до 1 млрд. паролей в секунду (зависит от формата), прирост быстродействия по сравнению с универсальными процессорами достигает десятков раз.
Давай подумаем, а для каких еще задач нам вообще могут понадобиться такие вычислительные возможности? К примеру, многие системные администраторы применяют на своих беспроводных точках доступа не штатную защиту, а усиленную (RSN/RSNA) с использованием WPA и WPA2. И почему бы не попробовать ее взломать?
Кодируем видео
Пионером nVidia в мире CUDA стал конвертор Badaboom, довольно простая утилита от Elemental Technologies, призванная нейтрализовать шумиху вокруг AMD ATI Avivo Video Converter. По сути, ты можешь импортировать видео практически любого типа (даже .m2ts с рипов Blu-ray), выбирать целевое устройство (от YouTube до BlackBerry Bold), после чего ты получишь оптимизированный файл .mp4. Всё максимально просто, вряд ли можно было сделать перекодировщик видео ещё более доступным. Следует отдать должное Elemental и Nvidia за добавление функциональности multi-GPU. Ты не можешь распределить одну работу CUDA по нескольким GPU, но ты можешь запустить по одной программе Badaboom 1.1 для каждого GPU в системе с поддержкой CUDA - удобная функция, если нужно переконвертировать много файлов. Если необходимо только перекодирование, а монтаж не требуется, то утилита Badaboom станет самым оптимальным вариантом. Badaboom нагружает CPU меньше, чем большинство кодировщиков. В конце концов, мало у кого есть компьютеры, выделенные для обработки видео, тем более в нашем приближении к обычным пользователям. В целом, чем выше качество кодирования, тем сильнее Badaboom нагружает GPU, оставляя CPU заниматься своей работой. Тут надо сказать, что Badaboom вообще не работает без CUDA.
И еще из области видео. Продукт CyberLink PowerDirector 7 позволяет распараллелить часть процессов и в особенности по части наложения на картинку разных эффектов. Известный перекодировщик TMPGEnc также поможет основному процессору расправится с включенными во время кодирования фильтрами, хотя просто ускорить процесс за счет CUDA не позволит.
Поддается и WPA
Пару номеров назад мы рассказывали о разработке компании Elcomsoft - Elcomsoft Wireless Security Auditor, которой с использованием CUDA удалось добиться производительности в 10-15 раз быстрее при подборе ключа WPA. К сожалению, продукт платный, а потому мы решили найти бесплатную альтернативу, которой стал открытый проект pyrit (http://code.google.com/p/pyrit).
pyrit нацеленн на взлом WPA PSK, на котором мы и остановимся. Рассмотрим, почему WPA-PSK (1/2) реально взломать. Ниже приведена схема подключения клиента к точке доступа. Стало быть, пользователь находит сеть и начинает коннект. Он вводит пароль, который вместе с названием сети (SSID) формирует парный ключ (Pairwise Master Key — PMK). Затем клиент объясняет точке доступа, что он хочет авторизироваться. В ответ точка доступа генерит произвольное число. Тогда клиент вырабатывает свое число, состоящее из белиберды, полученного случайного числа точки доступа и PMK — все это называется Pairwise Transient Key. Разберем случай, когда название сети (SSID:WLAN) нам известно. Pyrit сгенерит множество PMK-ключей в единую таблицу (не секрет, что любое вычисление может быть представлено в виде таблицы), которую в дальнейшем можно скормить уже существующему софту для взлома WPA (coWPAtty). Итак:
  pyrit.py -e WLAN

  create_essid pyrit.py -f dict.txt

  import_passwords (импортируем словарь паролей)

  pyrit.py batchprocess (процесс генерации пошел)
Полученные результаты можно смело экспортировать:
pyrit.py -e WLAN -f output.cow export_cowpatty
GPU позволяет нам сгенерировать за гораздо меньший срок огромное число PMK. С их помощью процесс взлома WPA-PSK заметно уменьшается по времени. На YouTube есть ролик, в котором демонстрируется кластер собранный из 15 компьютеров с GeForce 8800 GT на борту, а параллелизация достигнута с использованием проекта mpi4py (mpi4py.scipy.org/).
Не панацея
Нужно понимать, что CUDA не панацея. Нельзя просто взять приложение, добавить к нему модуль CUDA и получить супер-быстрое приложение. Использовать технологию можно только в том случае, если в коде приложения есть блоки, которые можно распараллелить. Этим и объясняется тот колоссальный прирост производительности в переборщиках паролей и сложность внедрения в готовые продукты, например, для кодирования видео.
Какие видюхи подходят для использования CUDA?
Полный перечень графических адаптеров, поддерживающих технологию CUDA, приведен на официальном сайте NVIDIA: http://www.nvidia.com/object/cuda_learn_products.html. На практике это практически все модели GeForce GeForce 8, 9, 100, 200 серий, а также NVidia Tesla и Nvidia Quadro.
WWW
- Библиотека jCUDA для работы с CUDA для Java-программистов:http://www.gass-ltd.co.il/en/products/jcuda/
- Модуль CUDA для Python:http://mathema.tician.de/software/pycuda
- Реализация для .NET: http://www.gass-ltd.co.il/en/products/cuda.net/
INFO
У компании ATI также есть аналогичный проект, который называется ATI-Stream (http://ati.amd.com/technology/streamcomputing/). NVIDIA, ATI и ряд других компаний работают над открытым стандартом OpenCL.