| Издательский дом ООО "Гейм Лэнд" | ЖУРНАЛ ХАКЕР #124, АПРЕЛЬ 2009 г. |
Питон для матерых хардкорщиков. Куем ассемблерные вставки в Python с помощью кошерного CorePy
Алексей Черкес (aleksey.cherkes@gmail.com)
Я постоянно использую в работе open source программы и не перестаю удивляться, какие необычные проекты порой зарождаются в этой свободной среде. На мой взгляд, коммерческие приложения никогда не будут отличаться таким полетом мысли, как в среде открытого ПО.
Осваивая подобные продукты, глубже понимаешь сложные концепции программирования, детальнее изучаешь интересные технологии. В этот раз речь пойдет о вещах немного непривычных. Я расскажу о скрещивании двух языков программирования: ассемблера и Python’a.
Такой тандем нечасто встречается на практике, ведь эти два языка решают абсолютно разные задачи: ассемблер максимально приближен к аппаратуре, предоставляет программисту над ней полный контроль, но программирование на нем - долгое, иногда нудное и кропотливое занятие, требующее нечеловеческой внимательности и терпения. Python, наоборот, проектировался так, чтобы максимально облегчить труд программиста. Это очень комфортный язык, который доступен каждому.
На первый взгляд, смесь двух подходов выглядит едва ли возможной. В Python даже нет понятия указателя, – тут вообще не идет речи о прямой работе с памятью, ведь всю грязную работу выполняет трудолюбивый garbage collector! А такие вещи, как динамическая типизация и функции, являющиеся объектами первого класса и делающие интеграцию с ассемблером, казалось бы, неразрешимой на практике задачей? Однако в этой статье я рассмотрю технологию CorePy, которая делает подобную интеграцию возможной.
Общий обзор
CorePy - это модуль расширения для Python, частично написанный на С. Он позволяет программисту писать и исполнять ассемблерные программы, работая исключительно с интерпретатором Python. Это дает возможность проводить машинно-зависимую оптимизацию Python-программ, которая обычно невозможна даже в случае использования таких языков, как C. К примеру, ты можешь напрямую использовать технологии наподобие MMX и SSE.
CorePy поддерживает процессоры x86, x86_64 (с поддержкой SSE), PowerPC (PPC32 и PPC64), VMX/AltiVec и Cell SPU. Он может работать в операционных системах linux и OS X. Microsoft Windows в списке почему-то не значится ;).
Весь CorePy можно разбить на три основных слоя:
- Instruction Set Architectures (ISAs). Это библиотеки объектов, которые представляют собой инструкции из разных наборов команд. Один физический процессор может поддерживать несколько наборов команд (например, x86 и SSE).
- InstructionStreams или потоки команд. Это контейнеры для объектов из пункта 1. Отвечают за хранение последовательности инструкций и за взаимодействие с операционной системой для их исполнения.
- Processors. Выполняют потоки команд и отвечают за передачу и возврат аргументов. Возможно синхронное и асинхронное выполнение потоков.
В начале работы программисту необходимо создать один из объектов InstructionSream. Затем пустой поток команд наполняется другими объектами, каждый из которых однозначно идентифицирует машинную инструкцию и ее параметры. На данном этапе никакого кода реально не создается! Мы просто описываем нужную нам программу, наполняя коллекцию InstructionSream. Полученная последовательность передается на исполнение классу, представляющему абстракцию процессора. Внутренние механизмы CorePy парсят переданный нами InstructionStream и генерируют на его основе реальный машинный код. Теперь его можно вызывать почти как обычную функцию, обращаясь к нему через специальный интерфейс класса Processor.
Руки чешутся работать
Пришло время испытать эту штуку в боевых условиях! Давай реализуем какой-нибудь несложный алгоритм двумя способами: на ассемблере и на обычном Python, а затем сравним оба метода по скорости работы и удобству программирования. Для этих целей я выбрал всем знакомую задачу сортировки массива методом пузырька. Делаем огромный массив с тысячами элементов, заполняем его убывающей последовательностью целых чисел (это самый сложный расклад для пузырька, если учесть, что сортировать мы будем по возрастанию). Задачу я решаю четырьмя методами:
- Тупая, наивная сортировка, реализованная на чистом Python без всяких примочек;
- То же самое, только с оптимизацией средствами PsyCo;
- Собственная реализация на ассемблере;
- Стандартная функция sort, предоставляемая интерпретатором.
Время работы замеряется с помощью модуля timeit. Собранная статистика отражена на графиках. Они сгенерированы с помощью библиотеки PyLab - опенсорсовом убийце MatLab. Самый главный листинг, содержащий CorePy-код, помещен на врезке. Кроме основных компонент, в поставку CorePy входит модуль printer для отображения созданных инструкций в привычном формате. Я не стал упускать хорошей возможности воспользоваться им – на соседней врезке помещен ассемблерный листинг в формате NASM. Наверное, его можно даже скомпилировать :). Глядя на обе врезки, ты без труда поймешь, как работает CorePy. Про модуль PsyCo и более высокоуровневую оптимизацию Python-программ ты можешь прочитать в предыдущем номере ][.
Как уже было сказано, CorePy поддерживает несколько процессорных архитектур. Все примеры я привожу для x86 как для самой распространенной и единственной мне знакомой :). Программные модели отличаются друг от друга в основном наборами команд. Для работы с тем или иным набором необходимо импортировать corepy.arch.*.isa (вместо * подставь имя архитектуры).
В этих модулях находятся объекты, из которых потом компонуются программы. Для начала работы создай экземпляр InstructionStream (в примере это code). Затем с помощью метода add в него заносятся конкретные команды, например:
code.add(x86.mov(eax, 0)).
Мы добавили к командам из code операцию обнуления eax. Примерно так и составляется вся программа. x86 - это псевдоним для соответствующей ISA. Для того чтобы все время не писать code.add(команда), можно просто вызвать функцию x86.set_active_code(code) для экземпляра твоей ISA. После этого все создаваемые инструкции будут автоматически добавляться к code. Названия и структура параметров команд полностью совпадают с ассемблерными аналогами, поэтому запомнить их не составляет труда.
Для работы с регистрами импортируй все имена из corepy.arch.x86.types.registers. Далее в параметрах команд просто пиши, что нужно: eax, bp и т.д.
Здесь есть одна хитрость: регистры - это обычные объекты. Поэтому для них можно вводить псевдонимы. В примере я ввел альтернативное имя is_finish для esi. Такой подход облегчает восприятие, как правило, сильно запутанных ассемблерных программ.
Механизмы адресации традиционно считаются сложным аспектом в программировании на ассемблере. Действительно, x86 поддерживает несколько ее типов: прямая, косвенная, базовая, индексная, со смещением и т.д. В этих разновидностях немудрено заблудиться. Для формирования указателей на ячейки памяти CorePy предоставляет удобный класс MemRef (передается как параметр соответствующим конструкторам команд), который может заметно облегчить работу и повысить визуальную наглядность кода. Например: MemRef(0xABCD) - указатель на абсолютный адрес, MemRef(rip, -1024) - указатель на ячейку памяти, смещенную относительно IP, MemRef(rsi, disp = 0, index = rcx, scale = 4) - эффективный адрес = base + (index * scale) + disp (индексная базовая адресация со смещением). Последний случай используется в примере.
Редкая программа выполняется линейно и может обойтись без меток для переходов. Объекты меток в CorePy создаются классами InstructionStream – выглядит приблизительно так: lbl_loop = code.get_label("LOOP"). Здесь lbl_loop - это новая метка, а code - поток команд. Если у code запросить еще одну метку с именем «LOOP», вернется тот же экземпляр. Для использования созданной метки ее нужно поместить в код. Это очень просто: code.add(lbl_loop) добавляет метку на текущую позицию в коде. Концепция раздельного создания и использования меток может показаться странной, но она необходима для организации прыжков на метки, которые идут впереди по коду.
Если ты изучил ассемблерный листинг нашей программы, то наверняка обратил внимание, что CorePy разделяет каждую функцию на три части и вводит предопределенные метки: PROLOGUE, BODY, и EPILOGUE. Все, что мы пишем, попадает в главную часть - BODY. Код эпилога и пролога генерируется автоматически. Он нужен для обеспечения бинарного интерфейса между функцией и внешним миром. Наличие такой автоматизации - еще одно преимущество CorePy: теперь программист тратит меньше сил на реализацию рутинных вещей, таких как инициализация регистра bp указателем на вершину стека и т.п.
CorePy использует стек для передачи параметров в функции. На стороне Python-кода для этого нужно использовать специальный класс ExecParams. У него есть восемь полей: p1, p2, ... , p8 – каждое соответствует одному из восьми параметров, которые можно передать в функцию. Такой объект передается экземпляру класса Processor во время запуска процедуры. Из ассемблера доступ к параметрам осуществляется по старинке: через смещение относительно указателя начала стека. Чтобы, например, скопировать первый параметр в eax, напиши следующее: x86.mov(eax, MemRef(ebp, 16)). Для возврата значений из функций используется регистр с предопределенным именем. Обычно это gp_return.
Разумеется, ассемблер имеет смысл применять для обработки больших массивов данных - только в этом случае можно увидеть повышение быстродействия. Но много информации через регистры и стек в функцию не передашь, и эта проблема имеет отдельное решение. Например, можно пользоваться классом array из стандартной библиотеки. Это обычный динамический гомогенный массив для Python. Среди встроенных типов есть только гетерогенные списки, но они неэффективны при работе с большими блоками однотипных элементов. К тому же, они не предоставляют прямого доступа к памяти, а это нужно для работы ассемблерного кода. Поэтому и появился класс array – у него есть метод buffer_info(), возвращающий адрес начала массива и количество элементов в нем. Этот адрес можно использовать напрямую из ассемблера, в своем примере я так и сделал.
CorePy предоставляет похожий класс с почти идентичным интерфейсом - extarray. В отличие от стандартного array, он всегда выделяет память, выровненную по границам страниц. За счет такой оптимизации твои программы будут работать максимально эффективно. Плюс, на Linux поддерживается технология huge pages, и ее использование абсолютно прозрачно для программиста.
Иногда очень удобно использовать средства Python для автоматизации создания потоков команд. Ты можешь написать программы, которые будут автоматически генерировать последовательности ассемблерных инструкций. В примерах, которые идут с CorePy, можно встретить такие участки кода:
for i in xrange(0, 65):

code.add(x86_isa.pop(edi))
Здесь вместо того, чтобы заниматься copy and paste, разработчики написали цикл, который создает 65 pop-инструкций, идущих друг за другом. Я думаю, развив эту идею, можно сделать библиотеку удобных макросов – и использование старого доброго asm’а станет еще комфортнее.
Анализируем результаты
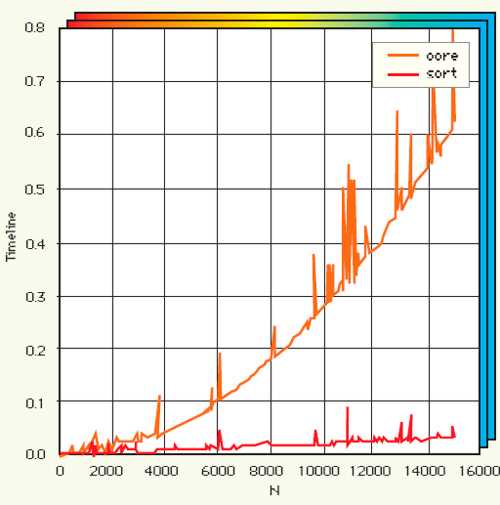
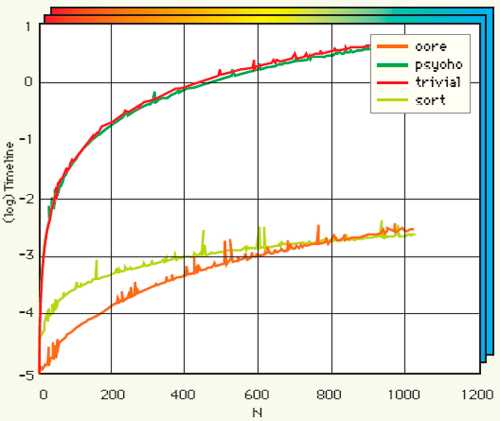
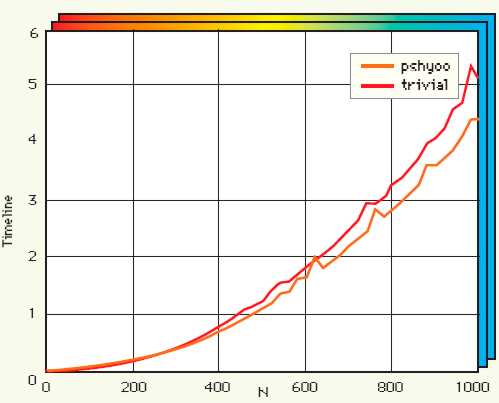
Выходит, ассемблерная версия рвет обычную на несколько порядков! Мы получили выигрыш от тысячи до десяти тысяч раз по скорости при использовании одинакового алгоритма, и с ростом количества элементов в массиве этот отрыв становится все заметнее. На графиках с четырьмя кривыми я вывел зависимость логарифма времени выполнения от количества элементов. Я провел два эксперимента с малым и большим N (до тысячи и до семи тысяч) – на графиках с двумя линиями выводятся абсолютные величины и сравниваются методы с приблизительно одинаковым порядком производительности. На одном показано время выполнения Python-реализации с PsyCo-оптимизацией и без.
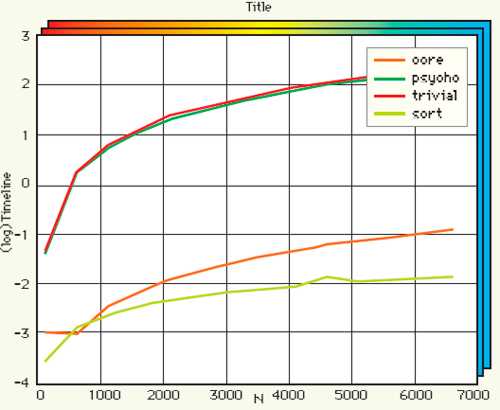
Видно, что PsyCo работает, но в этом тесте эффект, все же, не слишком убедителен - кривые идут почти одна под другой. На другом графике мы наблюдаем стандартную функцию sort против нашей ассемблерной реализации – sort работает приблизительно на один порядок быстрее с нашим количеством элементов, но заметна тенденция к увеличению этого разрыва. Связано это с тем, что встроенные функции пишут на C, и они обычно очень хорошо оптимизированы. И конечно, там используется алгоритм с меньшей сложностью, чем n**2, как у нашей bubble sort :). Это очень хорошо прослеживается на графиках.
Подведем итоги
Позволяя писать низкоуровневые процедуры прямо в Python-коде с использованием его синтаксиса, CorePy снижает порог вхождения в машинное программирование до минимума. На официальном сайте приведена цитата одного из пользователей. Он говорит, что CorePy опять сделал программирование на ассемблере увлекательным и веселым занятием. Я полностью разделяю это мнение: библиотека логична и последовательна, ее освоение не займет много времени, а от комфортного программирования получаешь почти феерическое удовольствие :). Важно, что количество программ, используемых в рабочем процессе, при этом не увеличивается. Ты по-прежнему работаешь с одним Python-интерпретатором, а значит, не нужно читать документацию к незнакомым компиляторам и другим утилитам, которыми ты никогда не пользовался (или пользовался, но давно). Это может служить хорошим стимулом для использования CorePy в промышленном программировании. Библиотека найдет применение в самых разных областях: встраиваемые приложения, научные расчеты, производство игр – и так далее. Отличная технология!
Код нашей функции на CorePy
  import corepy.arch.x86.isa as x86

  import corepy.arch.x86.platform as env

  from corepy.arch.x86.types.registers import *

  from corepy.arch.x86.lib.memory import MemRef
code = env.InstructionStream()

  lbl_begin = code.get_label('BEGIN_ALL')

  lbl_loop = code.get_label('BEGIN_LOOP')

  lbl_le = code.get_label('LE')

  lbl_end = code.get_label('END_LOOP')

  is_finish = esi # флаг завершения

  x86.set_active_code(code)
# Непосредственно функционал

  # Принимаем через стек два параметра:

  # начальный адрес массива и максимальный

  # допустимый индекс в нем.

  code.add(lbl_begin)

  x86.mov(is_finish, 0)

  x86.mov(ecx, 0)
code.add(lbl_loop)

  # Заносим в edi адрес начала массива

  # Он всегда состоит из 4байтных целых чисел

  x86.mov(edi, MemRef(ebp, 8))

  x86.mov(eax, MemRef(edi, disp = 0, index = ecx, 4)

  x86.mov(ebx, MemRef(edi, disp = 4, index = ecx, 4)
# Если порядок сортировки нарушен...

  x86.cmp(eax, ebx)

  x86.jle(lbl_le)
# меняем элементы местами

  x86.mov(is_finish, 1)

  x86.mov(MemRef(edi, disp = 0, index = ecx, 4), ebx)

  x86.mov(MemRef(edi, disp = 4, index = ecx, 4), eax)
code.add(lbl_le)

  x86.inc(ecx)

  x86.cmp(ecx, MemRef(ebp, 12)) # уже конец?

  x86.je(lbl_end)

  x86.jmp(lbl_loop)

  code.add(lbl_end)
# Если не было ни одной перестановки,

  # то массив отсортирован.

  x86.cmp(is_finish, 0)

x86.jne(lbl_begin)
Машинный код, созданный CorePy на основе нашего. Выведен в формате NASM
  # Platform: linux.spre_linux_x86_32

  BITS 32

  SECTION .text

  global bubble_sort

  bubble_sort:
PROLOGUE:

  push ebp

  mov ebp, esp

  push edi

  push esi

  push ebx
BODY:
BEGIN_ALL:

  mov esi, 0

  mov ecx, 0
BEGIN_LOOP:

  mov edi, dword [ebp + 8]

  mov eax, dword [edi + ecx * 4 + 0]

  mov ebx, dword [edi + ecx * 4 + 4]

  cmp eax, ebx

  jle LE

  mov esi, 1

  mov dword [edi + ecx * 4 + 0], ebx

  mov dword [edi + ecx * 4 + 4], eax
LE:

  inc ecx

  cmp ecx, dword [ebp + 12]

  je END_LOOP

  jmp BEGIN_LOOP
END_LOOP:

  cmp esi, 0

  jne BEGIN_ALL
EPILOGUE:

  pop ebx

  pop esi

  pop edi

  leave

  ret
Запуск нашей сортировки
import corepy.arch.x86.platform as env
proc = env.Processor()

  params = env.ExecParams()
def sort(array):

  bi = array.buffer_info()

  # Подготовка параметров

  params.p1 = bi[0]	   # начало массива

  params.p2 = bi[1] - 1  # количество элементов

  # Запуск asm - кода!

  proc.execute(code, params = params)
DVD
На диске тебя ждут все сорцы к статье, архив CorePy из SVN с примерами и документацией, а также модули SciPy, NumPy и matplotlib, необходимые для построения графиков.
WWW
- www.corepy.org – официальный сайт проекта. Единственный источник информации по теме!
WARNINIG
CorePy реализован только под Linux и OS X. Версии для Windows не существует в природе!