Сначала было Слово. Потом люди научились его произносить и понимать, а спустя еще некоторое время захотели разобраться, что же это такое - речь... Как люди общаются с помощью звуков? Как в шумах и при плохой слышимости понимают передаваемое им сообщение? Как иногда по одному-двум словам узнают знакомый голос собеседника? И почему никак не могут научить тому же "умную" машину - компьютер?
Оказывается, не все так просто. С одной стороны, в речевом сигнале содержатся некоторые структуры, соответствующие инвариантным языковым символам, общие для людей, говорящих на одном языке (иначе мы не могли бы понимать друг друга). Они - основа понимания человеком речевого сообщения. С другой - голос и речевые навыки каждого человека строго индивидуальны - и это основная аксиома распознавания (различения) дикторов.
Отделение инвариантного от индивидуального, соотнесение непрерывного и постоянно меняющегося речевого сигнала с конечным числом дискретных фонем (или аллофонов), выявление и классификация индивидуальных признаков, отличающих одного человека от других, ему подобных, - все это общие вопросы распознавания речи, сводящиеся так или иначе к идентификации диктора, его верификации и преобразованию речи в текст. Причем подход к распознаванию речи во многом схож: что у лингвистов, что у экспертов-криминалистов, что у программ автоматического распознавания речи.
Как изучают речь?
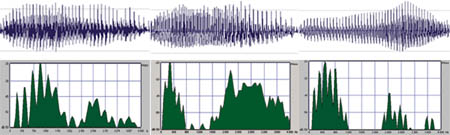
Современный персональный компьютер в реальном времени может представить речь графически - во временной или спектральной области. Осциллограмму речи можно получить с помощью обычного микрофона и звуковой карты, а обработать и проанализировать простейшим звуковым редактором. Более информативный способ анализа - это спектральное представление, когда акустический сигнал представляется в виде наложения большого числа синусоид. Разложение сигнала в спектр обычно проводится с помощью быстрого преобразования Фурье - БПФ (см. ##31, 32 [259, 260], 13 [291], 14 [292]), реализованного в большинстве компьютерных звуковых редакторов и специальных программ обработки речи.

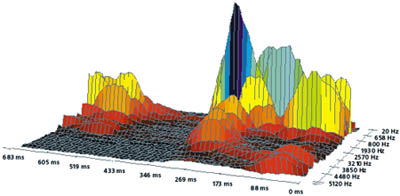
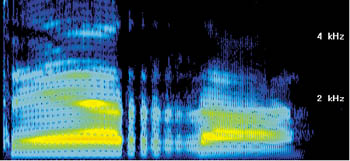
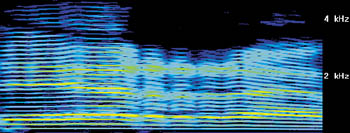
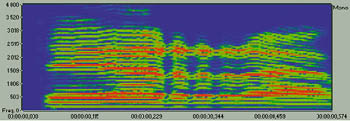
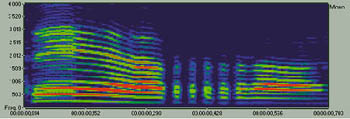
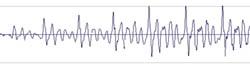 Рис. 6.