При передаче речи по цифровым каналам связи, будь то сотовая или Интернет-телефония, самый важный вопрос - это сколько информации (число бит в единицу времени) придется передавать по каналам, чтобы снабдить пользователя качественной голосовой связью. Ответ на него в каком-то смысле определяет все - стоимость и качество предоставляемых пользователям услуг и аппаратуры, емкость и масштабируемость сети передачи данных и многое другое. Давайте посмотрим, с чем на сегодняшний день мы имеем дело, а чтобы было понятнее, о чем идет речь, загляните во врезку.
Сжатие речи при ее передаче сокращает объем передаваемых данных, затраты и, благодаря этому, позволяет снижать цены на услуги и привлекать новых пользователей. Именно поэтому рынок цифровой телефонии развивается под непосредственным технологическим диктатом ученых и разработчиков кодеков речи.
Очевидно, что только начиная с каких-то пороговых значений соотношения скорости передачи и доступной емкости каналов операторы связи имеют достаточную (для развития и своего, и рынка) прибыль. В настоящее время можно сказать, что этот порог уже превышен. Это привело к тому, что расценки на цифровую связь стали более чем конкурентны по сравнению с проводной аналоговой, а благодаря скорому переходу к кодекам речи на скорости порядка 2,4 кбит/с и ниже, цена минуты междугородного разговора может в ближайшие годы снизиться до нескольких центов за минуту. Тут уже из-за массовости услуги можно говорить о сверхприбылях, и неудивительно, что только ленивый на рынке сегодня не косит глаз в сторону услуг передачи речи.
Сказав про успехи, нельзя не сказать хотя бы пару слов и о недостатках. Качество звучания сжатой речи, что в сотовой, что в Интернет-телефонии, мягко говоря, "не очень". Некоторые (из тех, конечно, кто имеет такой выбор) до сих пор предпочитают аналоговые сотовые сети цифровым, поскольку в последних речь часто звучит механически, случаются посторонние звуки и т. п. - и все из-за сжимающих кодеков речи, так как в остальном цифровые протоколы передачи обеспечивают лучшее качество звучания. В компьютерной телефонии снижению качества мы, помимо кодеков речи, обязаны заметным запаздываниям сигнала и ошибкам при сборке пакетов. Впрочем, это болезни роста: понятно, что если с кодеком на 2,4 кбит/с "узкий" канал справляется с трудом, то на скорости 1,2 кбит/с проблем будет меньше. Да и пропускная способность компьютерных сетей возрастает настолько быстро, что в ближайшей перспективе сетевая задержка снизится в несколько раз и дефекты сборки пакетов будут маловероятны или исчезнут. И тогда и у пользователей, и у операторов на первое место могут встать высокие требования именно к низкоскоростным кодекам речи.
Речь представляет собой колебания сложной формы, зависящей от произносимых слов, тембра голоса, интонации, пола и возраста говорящего. Спектр речи весьма широк (примерно от 50 до 10000 Гц), но для передачи речи в аналоговой телефонии когда-то отказались от составляющих, лежащих вне полосы 0,3-3,4 кГц, что ухудшило восприятие ряда звуков (например, шипящих, существенная часть энергии которых сосредоточена в верхней части речевого спектра), но мало затронуло разборчивость. Ограничение частоты снизу (до 300 Гц) также ухудшает восприятие из-за потерь низкочастотных гармоник основного тона. А в цифровой телефонии к влиянию ограничения спектра добавляются еще шумы дискретизации, квантования и обработки, дополнительно зашумляющие речь.
Решающими в выборе полосы 0,3-3,4 кГц были экономические соображения и нехватка телефонных каналов. Более того, в те времена, когда время ожидания заказанного разговора составляло десятки часов, экономические ограничения привели к установке на трансконтинентальных линиях США и атлантическом кабеле так называемой аппаратуры J2, каналы которой и вовсе имели полосу 0,3-1,7 кГц. Такая аппаратура некогда работала и на линии Москва-Владивосток. Качество ее каналов едва достигало двух баллов MOS, но решающим оказалось двукратное увеличение числа телефонных соединений. Потребности пользователей в каналах сделали тогда вопросы качества речи второстепенными.
Для совместимости по полосе с распространенными аналоговыми сетями в цифровой телефонии отсчеты аналоговой речи приходится брать согласно теореме Котельникова с частотой 8 кГц - не меньше двух отсчетов на 1 Гц полосы. Правда, в цифровой телефонии существует принципиальная возможность использовать спектр речи за пределами полосы 0,3-3,4 кГц и тем самым повысить качество, но эти методы не реализуются, так как они вычислительно пока еще очень сложны. Впрочем, кое-что появляется: уже разработаны универсальные кодеки для компьютерной телефонии и мультимедиа, способные пристойно передавать не только речь, но и музыку. При полосе исходного сигнала до 6 кГц и тактовой частоте отсчетов около 16 кГц сжатый цифровой сигнал требует для передачи канал в 12 кбит/с. При этом оценка качества по критерию MOS может быть выше 4,5 балла.
Более подробно о механизмах речеобразования можно прочесть в соседних с этой статьях, а нам важно вот что: озвученная речь, представляющая большую трудность для сжатия, образуется с помощью звуковых связок человека. Скорость их периодических колебаний задает так называемую частоту основного тона (ОТ) - периодическую подпитку энергией голосового тракта человека, который представляет собой объемный резонатор. Голосовой тракт формирует спектральную окраску речи, или, другими словами, ее формантную структуру. Другое название голосового тракта - синтезирующий фильтр - нам более удобно, так как математическое описание речеобразования обычно ведется в терминах линейной фильтрации. Тогда, условно, речевой сигнал можно разделить на две составляющие, отвечающие за (1) ОТ (возбуждение фильтра) и (2) голосовой тракт (формантная структура сигнала). Соответственно, большинство на сегодня используемых алгоритмов, так или иначе, решают один вопрос - как наиболее эффективно выделить и сокращенно описать обе составляющие. А отрезки глухой речи при моделировании заменяют спектрально окрашенным шумом.
| | Линейное предсказание
Вкратце очень красивая идея линейного предсказания (ЛП) такова: сформировать из нескольких отсчетов речи линейную комбинацию, наиболее точно аппроксимирующую следующий отсчет (формула 1). Для этого сигнал речи сегментируют на блоки, обрабатывают окном и для каждого блока вычисляют автокорреляционную функцию (АКФ), число отсчетов которой обычно около 10. Оказывается, что такая АКФ содержит исчерпывающую информацию о формантном спектре речи на данном сегменте. На втором шаге находят решение системы линейных уравнений относительно коэффициентов предсказания - тех самых, что нужны для формирования синтезирующего фильтра. Фактически найденные коэффициенты задают спектральную модель голосового аппарата человека, и чем выше порядок ЛП (Р в формуле 1), тем точнее модель.
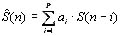 (1)
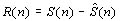 (2)
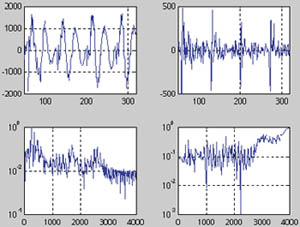
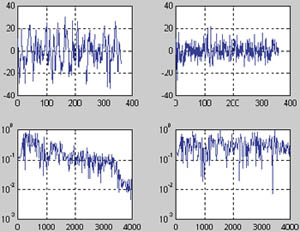
Пропустив исходную речь через фильтр, обратный полученному, мы получаем функцию, близкую к сигналу возбуждения. В ее спектре формантные области сглажены, а спектральный характер напоминает белый шум. Поэтому обратный фильтр также называют отбеливающим.
На третьем шаге параметры ЛП квантуются, после чего передаются на приемную сторону. А ошибка предсказания (разностный сигнал), обозначенный в формуле 2 через R(n), обрабатывается с целью выделения существенных для человеческого восприятия параметров. Например, в простейших кодеках ЛП передается период ОТ и мощность возбуждающих импульсов. В кодеке RPE-LTP таких импульсов уже несколько, а в кодеках CELP (code-excited linear prediction - ЛП с кодовым возбуждением) вместо передачи самих импульсов подбирается наиболее подходящая запись из набора хранящихся в заранее сформированной кодовой книге. Тогда, вместо самой последовательности можно на прием передать ее порядковый номер в кодовой книге. Однако существуют и другие подходы.
В любом случае по каналу связи вместо самой речи передают так или иначе выделенные и квантованные параметры предсказания, интервал и усиление ОТ, параметры возбуждения.
В декодере ЛП по принятым параметрам восстанавливают сигнал возбуждения, пропускают его через синтезирующий фильтр и так восстанавливают речь. | |